
Sumário Analítico do Artigo
- O Surgimento do Jev e a Crise de Eficiência dos Chatbots
- A Visão dos Fundadores: Quem é Diogo Almeida e a Criação da TypeSafe AI
- Fundamentos Cognitivos: Sistema 1 vs Sistema 2 na Inteligência Artificial
- Por que Forçar LLMs a Tomar Decisões Estruturadas é um Erro Arquitetural
- Arquitetura Sob o Capô: Como o Jev Opera sem Autoregressão
- O Método RLCD: Reinforcement Learning from Calibrated Decisions e a Matemática de Incerteza
- As Três Primitivas Centrais: Noul, Choice e Score em Detalhes
- A Economia Radical de Tokens e o Paradoxo de Jevons Aplicado à Computação
- Comparativo Direto: Jev vs GPT-4o, Claude 3.5 Sonnet, Gemini Flash e Llama 3
- Engenharia Prática: Tutorial Completo com TypeSafe Python SDK, REST API e LangGraph
- Padrões de Integração Híbrida: Jev como Roteador e Guardrail para Agentes LLM
- Casos de Uso Corporativos: Suporte, Fraude, Triage de Incidentes e E-commerce
- Limitações Estruturais, Críticas do Mercado e o Conceito de ‘Modelo Mudo’
- Vídeos de Referência, Entrevistas e Discussões Técnicas
- Perguntas Frequentes (FAQ Técnico & Arquitetura)
- Referências Bibliográficas, Fontes Primárias e Leituras Recomendadas
1. O Surgimento do Jev e a Crise de Eficiência dos Chatbots
Ao longo dos últimos quatro anos, a indústria de tecnologia viveu uma verdadeira obsessão coletiva em torno dos Grandes Modelos de Linguagem (LLMs, na sigla em inglês). Desde o estrondoso lançamento do ChatGPT no final de 2022, passando pelas evoluções consecutivas do GPT-4, Claude 3.5 Sonnet e Gemini 1.5 Pro, a narrativa dominante determinava que o caminho supremo para a automação corporativa passava invariavelmente por modelos conversacionais cada vez maiores, mais densos e capazes de articular sentenças complexas em linguagem natural.
No entanto, enquanto o público leigo e os times de marketing se deslumbravam com a capacidade de um chatbot redigir poesias, ensaios acadêmicos ou resumos prolixos, os engenheiros de software e arquitetos de sistemas enfrentavam uma realidade muito mais árdua nos bastidores da infraestrutura corporativa. No mundo real do desenvolvimento de software, a esmagadora maioria dos gargalos operacionais não exige que uma máquina converse, conte histórias ou demonstre eloquência verbal. Softwares modernos precisam tomar decisões: classificar um tíquete de suporte que acabou de entrar na fila, rotear um pacote de rede, estimar se uma transação financeira possui indícios de fraude, priorizar um alerta no PagerDuty ou selecionar qual ferramenta um agente autônomo deve acionar em uma esteira de microsserviços.
Para resolver tarefas estritamente determinísticas e estruturadas como essas, os desenvolvedores eram obrigados a cometer o que muitos hoje consideram a maior heresia arquitetural da história recente da computação: instanciar um modelo generativo monumental com dezenas ou centenas de bilhões de parâmetros, pagar milhares de dólares em clusters de GPUs e esperar preciosos segundos enquanto a máquina emitia, token a token, um punhado de caracteres formatados precariamente em JSON.
Essa incompatibilidade fundamental gerou uma crise silenciosa, mas profunda, nos orçamentos de tecnologia e na estabilidade operacional de produtos digitais. Aplicações que deveriam responder com latência sub-segundo passaram a sofrer com esperas de 3 a 7 segundos. Pipelines de processamento em lote viram suas faturas de nuvem explodirem exponencialmente devido ao consumo insano de tokens em tarefas banais de classificação binária. O mercado sentia uma necessidade urgente de uma abordagem que resgatasse a eficiência da computação clássica sem abdicar da incrível flexibilidade semântica das redes neurais modernas.
Foi exatamente nesse cenário de frustração técnica e desperdício financeiro monumental que, em 15 de setembro de 2026, surgiu oficialmente a TypeSafe AI com o anúncio público do Jev. Apelidado imediatamente pela imprensa de negócios e veículos como o Brazil Journal e a Exame como “o ChatGPT dos softwares”, o Jev não foi concebido para manter conversas ou entreter usuários. Ele é categorizado como um modelo de Sistema 1: uma inteligência veloz, barata, silenciosa e tipada, cujo único propósito é ingerir o estado de uma aplicação e devolver respostas matemáticas e decisões probabilísticas calibradas em frações minúsculas de segundo.
O lançamento veio respaldado por uma robusta rodada de investimento semente (Seed Round) de US$ 40 milhões, liderada pela conceituada gestora de capital de risco DCVC (Data Collective), reconhecida globalmente por seus investimentos em tecnologias profundas (Deep Tech). Ao sair de seu período de desenvolvimento sigiloso (stealth mode), a TypeSafe AI não apenas entregou uma nova API ao mercado; ela inaugurou uma categoria inteiramente nova de primitivas computacionais, desencadeando um debate furioso entre defensores da abordagem de modelos gigantescos generalistas e proponentes de arquiteturas desacopladas e especializadas.
2. A Visão dos Fundadores: Quem é Diogo Almeida e a Criação da TypeSafe AI
Para compreender por que o Jev causou um impacto tão imediato e profundo nos círculos mais elevados da engenharia de IA do Vale do Silício, é imprescindível olhar para quem está por trás da sua concepção. O fundador e CEO da TypeSafe AI é o pesquisador brasileiro Diogo Almeida, cuja credibilidade técnica na história moderna da inteligência artificial generativa dispensa apresentações.
Antes de criar a TypeSafe AI em 2024 ao lado de seus cofundadores Erik Gafni e Sasha Sheng, Diogo Almeida integrou o seleto time de pesquisadores fundamentais da OpenAI e, anteriormente, os laboratórios de pesquisa do Google Brain. Na OpenAI, Diogo foi coautor direto de alguns dos artigos científicos mais transformadores da década, atuando diretamente no desenvolvimento das técnicas de RLHF (Reinforcement Learning from Human Feedback) e no clássico artigo que deu origem ao InstructGPT — o modelo precursor direto que permitiu à OpenAI transformar os descontrolados modelos de complementação de texto no que hoje conhecemos como ChatGPT e GPT-4.
Ironicamente, foi exatamente a sua posição privilegiada na gênese do ChatGPT que permitiu a Diogo Almeida enxergar a grande falha estrutural da indústria antes de quase todo mundo. Em entrevistas recentes e em sua aclamada participação no prestigiado podcast técnico Latent Space, conduzido por Swyx e Alessio Fanelli, Almeida desabafou sobre a distorção gerada pelo sucesso estrondoso dos chatbots:
“Nós passamos anos na OpenAI refinando técnicas para fazer modelos falarem de maneira fluida, empática e agradável aos seres humanos. Foi um triunfo impressionante de produto, mas acabou cegando a indústria. Nós condicionamos todo o mercado a achar que a interface universal da inteligência de máquina era a caixa de texto livre. Mas quando você olha para o interior dos sistemas corporativos, softwares não querem ler redações de três parágrafos; softwares operam com tipos primitivos, árvores de decisão, flags booleanas e matrizes de probabilidade. Forçar um desenvolvedor a pedir um JSON para um modelo generativo de 500 bilhões de parâmetros e depois usar expressões regulares e validação de schema para rezar para o código não quebrar é um absurdo computacional.”
Essa epifania técnica levou Diogo Almeida a se desvincular das Big Techs para erguer a TypeSafe AI. A tese central da empresa era clara e audaciosa: construir a primeira infraestrutura de inteligência artificial desenhada de ponta a ponta não para interagir com olhos humanos, mas sim para ser invocada como uma função determinística, tipada e extremamente performática pelo código de outras aplicações.
Ao seu lado, Erik Gafni trouxe anos de experiência na otimização de compiladores e kernels de GPU de baixíssima latência, enquanto Sasha Sheng aportou vasta experiência em sistemas distribuídos de alta resiliência e ingestão massiva de dados. A equipe reuniu veteranos que atuaram na infraestrutura de treinamento de redes neurais profundas nas principais empresas de tecnologia do Vale.
O apoio imediato de fundos de primeira linha como a DCVC e o entusiasmo precoce demonstrado por líderes de infraestrutura moderna — como Guillermo Rauch, CEO da Vercel — confirmaram que o diagnóstico de Almeida tocava em uma ferida aberta compartilhada por milhares de equipes de engenharia em todo o planeta. A promessa de uma IA desenhada para máquinas, e não para conversas de salão, ecoou instantaneamente como a resposta que a indústria aguardava para destravar a próxima fase da revolução da inteligência artificial.
3. Fundamentos Cognitivos: Sistema 1 vs Sistema 2 na Inteligência Artificial
O arcabouço teórico que fundamenta a existência do Jev busca inspiração direta na psicologia cognitiva moderna, em particular na seminal obra “Rápido e Devagar: Duas Formas de Pensar” (Thinking, Fast and Slow), publicada pelo psicólogo e vencedor do Prêmio Nobel de Economia Daniel Kahneman.
Kahneman dividiu os processos cognitivos do cérebro humano em dois grandes modos operacionais:
Sistema 1 (Fast & Intuitive)
Operação mental rápida, automática, intuitiva, quase subconsciente e com baixíssimo custo metabólico. É o sistema que você utiliza para reconhecer imediatamente uma expressão de raiva no rosto de alguém, frear o carro de forma reflexa quando um obstáculo surge na pista ou responder instantaneamente quanto é 2 + 2. Não há deliberação verbal sequencial; a resposta emerge de um mapeamento probabilístico instantâneo.
Sistema 2 (Slow & Deliberative)
Operação mental lenta, consciente, altamente deliberativa, analítica e custosa em termos de energia mental. É o sistema acionado quando precisamos calcular de cabeça 17 × 24, redigir uma petição jurídica complexa, avaliar prós e contras de um investimento imobiliário ou debater filosofia política. Ele funciona passo a passo, construindo cadeias lógicas explícitas.
Quando traçamos um paralelo com o estado atual da computação neural, fica evidente que os modelos autoregressivos como GPT-4, Claude e Gemini representam tentativas custosas de simular o Sistema 2 (e mais recentemente, com modelos de raciocínio encadeado como a família o1 da OpenAI, isso se tornou ainda mais pronunciado). Eles desdobram pensamentos sequenciais, geram cadeias de raciocínio verbais (*Chain of Thought*) e gastam imensas janelas de tempo produzindo prosa textual.
O problema, como salienta a equipe da TypeSafe AI, é que cerca de 90% das tarefas cognitivas que uma arquitetura corporativa precisa realizar diariamente pertencem exclusivamente ao escopo do Sistema 1. Quando uma mensagem chega ao WhatsApp de uma central de atendimento, determinar se o cliente está com raiva não exige uma dissertação sobre a psicologia humana; exige uma pontuação calibrada de 0 a 1 em milissegundos. Quando um e-mail é recebido, encaminhá-lo para a fila do Suporte Técnico ou para o Financeiro é uma escolha discreta entre alternativas categóricas fechadas.
Ao tentar utilizar um “Sistema 2 artificial” para executar reflexos do “Sistema 1”, as organizações acabaram criando uma aberração de engenharia: arquiteturas lentas, excessivamente caras, imprevisíveis e sujeitas a falhas bizarras de formatação de strings. O cérebro biológico não engaja o córtex deliberativo verbal para desviar de uma pedra que cai; ele dispara impulsos sensoriais e reflexos medulares instantâneos. O Jev surge como a materialização pura desse Sistema 1 algorítmico: ele não possui um monólogo interno verbal, ele não constrói frases; ele percebe o contexto e projeta diretamente os tensores de decisão calibrados.
4. Por que Forçar LLMs a Tomar Decisões Estruturadas é um Erro Arquitetural
Para entender a dor visceral que o Jev resolve na rotina diária das equipes de engenharia de software, precisamos analisar minuciosamente o ciclo de vida de uma requisição típica quando um desenvolvedor tenta usar um modelo de linguagem tradicional para tomar uma decisão.
Considere uma situação rotineira: classificar a gravidade e o departamento de um tíquete de suporte em um software corporativo de CRM. O fluxo convencional com LLMs costuma seguir a seguinte via crucis:
- Engenharia de Prompt Frágil: O desenvolvedor escreve um prompt de 50 linhas explicando o papel do assistente, detalhando os departamentos existentes, implorando para que o modelo “responda estritamente em JSON válido” e ameaçando que “qualquer texto conversacional antes ou depois do JSON quebrará a produção”.
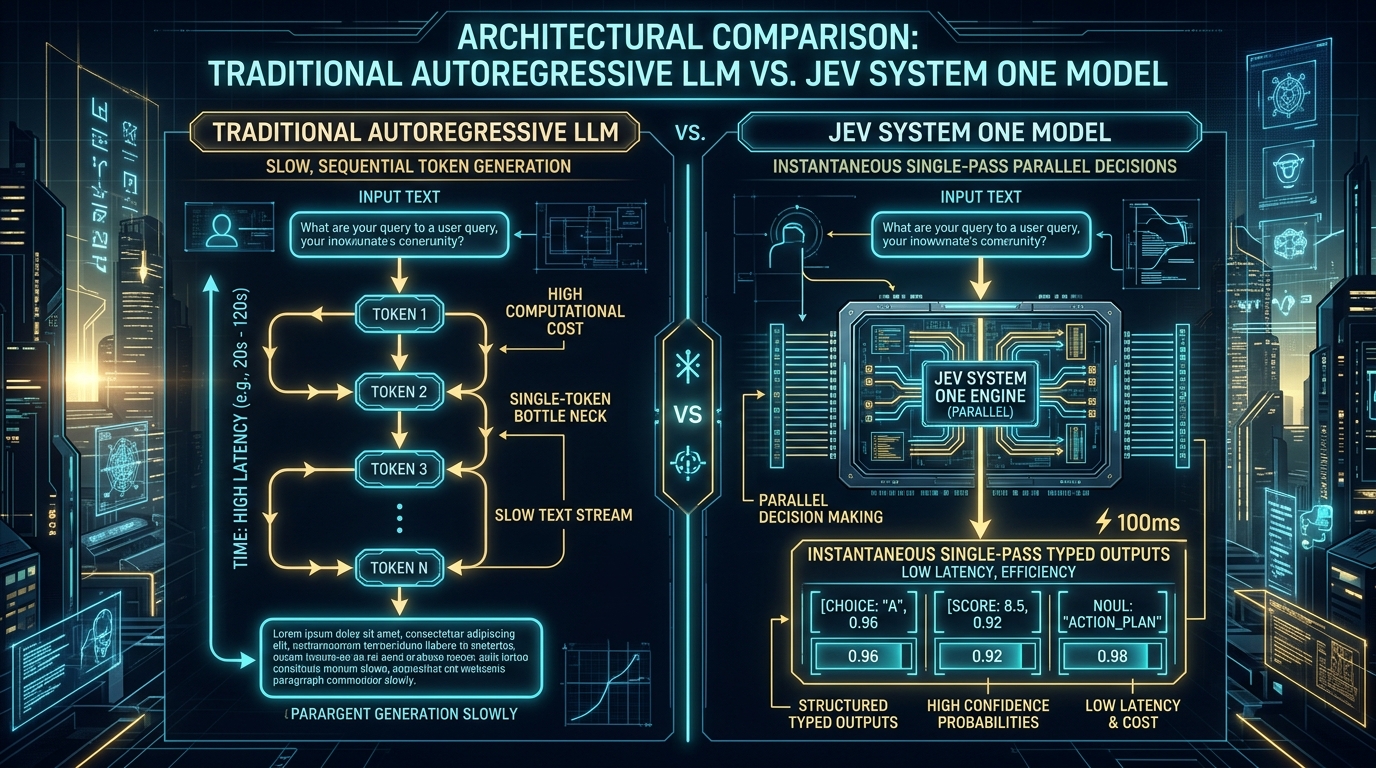
- Latência Autoregressiva: O LLM recebe a requisição. Como o modelo é autoregressivo, ele precisa predizer cada caractere ou token individualmente de forma estritamente sequencial. Para cuspir a chave
"departamento": "financeiro", o modelo precisou rodar dezenas de iterações através de centenas de camadas de transformadores, calculando probabilidades sobre um vocabulário de mais de 100.000 tokens apenas para emitir uma chave sintática. Esse processo consome entre 1,5 e 5 segundos inteiros. - O Drama dos Markdown Codeblocks: Mesmo com a introdução do “JSON Mode” ou “Structured Outputs” pelos provedores de nuvem, é rotineiro ver modelos envolvendo a saída em blocos do tipo
```json ... ```, adicionando quebras de linha inesperadas, truncando o payload se o limite de tokens for atingido ou inserindo vírgulas sobressalentes que invalidam o parser de JSON nativo da aplicação. - Parsing Defensivo e Retries: O backend do desenvolvedor precisa implementar bibliotecas defensivas de parsing (como Pydantic, Instructor ou Zod) e colocar loops de repetição (*retries*) custosos. Quando o JSON falha, uma nova chamada de US$ 0,05 precisa ser disparada, dobrando a latência do usuário final.
- Descarte de 95% do Processamento: No final das contas, o sistema consumiu milhares de watts de energia e dezenas de milhões de ciclos de GPU apenas para extrair uma única palavra daquele JSON (ex:
"financeiro") e usar um simplesif/elseno código. Todo o restante da estrutura foi sumariamente jogado no lixo da memória.
Além da latência e do custo exorbitante, existe outro problema crônico nos LLMs tradicionais: a ausência de probabilidades calibradas. Quando um modelo como o GPT-4o escolhe a opção “financeiro”, ele não fornece ao desenvolvedor uma métrica estatisticamente confiável de quão seguro ele está daquela resposta. As chamadas “logprobs” expostas por algumas APIs não representam a probabilidade real de acerto do modelo, mas sim a certeza dele na escolha do próximo token superficial no vocabulário. O resultado é o fenômeno da superconfiança cega: o modelo pode estar redondamente enganado, mas emite a resposta com o mesmo tom assertivo e confiante com que afirmaria que o céu é azul.
5. Arquitetura Sob o Capô: Como o Jev Opera sem Autoregressão
Como exatamente a TypeSafe AI conseguiu construir um modelo capaz de responder em até 70 milissegundos com uma taxa de precisão que rivaliza com os modelos mais caros do planeta? A resposta reside em uma rejeição deliberada do mecanismo autoregressivo clássico.
Nos modelos de linguagem generativos tradicionais, a geração ocorre via decodificação causal autoregressiva. Dada uma sequência de tokens $T_1, T_2, …, T_k$, o modelo computa a distribuição de probabilidade para o token $T_{k+1}$. Esse token é amostrado e anexado à sequência, servindo de entrada para computar $T_{k+2}$, e assim sucessivamente. Essa dependência temporal intrínseca impede a paralelização na geração: uma resposta com 200 tokens requer obrigatoriamente 200 passagens sucessivas pela rede neural, criando um gargalo físico intransponível na velocidade de transmissão de dados entre a memória HBM e os núcleos tensores das GPUs.
O Jev rompe com esse paradigma ao operar como um modelo não-autoregressivo de passagem única (single-pass forward evaluation). Quando uma requisição chega ao Jev, a arquitetura recebe simultaneamente:
- O Estado (State): Pode ser uma cadeia de texto não estruturada (ex: mensagem de cliente, e-mail, transcrição de áudio), um objeto JSON completo, um log de erro do Kubernetes ou um payload de telemetria.
- O Dicionário de Perguntas Tipadas (Questions): Um conjunto de perguntas pré-definidas pelo desenvolvedor, enquadradas obrigatoriamente em uma das primitivas da TypeSafe (Noul, Choice ou Score).
Em vez de converter as perguntas em um prompt de texto livre para tentar gerar texto, o Jev injeta as perguntas diretamente como cabeças de classificação e tensores de projeção nas camadas superiores do seu transformador bidirecional de alta capacidade. A rede processa o contexto de entrada uma única vez e projeta simultaneamente os valores de todas as perguntas em paralelo através de cabeçotes dedicados de decisão.
O resultado não é um fluxo de caracteres JSON que precisa ser transmitido pela rede e decodificado caractere a caractere. O resultado é um vetor binário e estruturado diretamente nos buffers do servidor, contendo valores escalares, índices categóricos e floats de probabilidade, entregues instantaneamente via HTTP ou gRPC em menos de 100 milissegundos.
6. O Método RLCD: Reinforcement Learning from Calibrated Decisions e a Matemática de Incerteza
Outra inovação monumental introduzida pela TypeSafe AI é a sua metodologia proprietária de treinamento, batizada de RLCD (Reinforcement Learning from Calibrated Decisions) ou Reforço por Decisões Calibradas.
Na história recente dos LLMs, a técnica predominante de alinhamento é o RLHF (Reinforcement Learning from Human Feedback), criada e popularizada por pioneiros como o próprio Diogo Almeida. O RLHF utiliza modelos de recompensa baseados nas preferências de avaliadores humanos. O efeito colateral bem documentado dessa abordagem é que ela incentiva os modelos a serem prolixos, excessivamente bajuladores e artificialmente assertivos, priorizando parecer plausível aos olhos humanos em detrimento de admitir incerteza estatística.
O RLCD foi concebido para seguir o caminho exatamente oposto. Em vez de treinar a rede para agradar avaliadores, o algoritmo de perda (*loss function*) do RLCD penaliza severamente o modelo quando ele expressa certeza sobre previsões errôneas e recompensa a perfeita calibração de probabilidade empírica (conhecida formalmente na literatura estatística como Brier Score Calibration e calibração de Platt).
O que significa “Calibração Estatística Perfeita”?
Se o Jev avalia 10.000 tíquetes de suporte e atribui a todos eles uma probabilidade de 0,85 (85%) de pertencerem à categoria “Financeiro”, uma calibração estatística perfeita significa que exatamente 8.500 desses tíquetes estarão de fato corretos e 1.500 estarão incorretos. Isso permite que engenheiros de software confiem no valor numérico da probabilidade como uma certeza matemática da distribuição, permitindo a criação de regras de negócio automatizadas do tipo: “se probabilidade >= 0,90 execute a ação imediatamente sem supervisão humana; se estiver entre 0,60 e 0,89, coloque na esteira de aprovação assistida; se for < 0,60, transfira para triagem humana especializada”.
Essa característica técnica elimina de raiz o risco de alucinações. Nos LLMs tradicionais, a alucinação decorre do espaço ilimitado de geração de tokens — a rede precisa continuar gerando palavras mesmo quando não possui evidência suficiente nos pesos sinápticos. No Jev, o espaço de resposta é estritamente delimitado e tipado (*bounded typed output space*). O modelo não pode inventar categorias que não foram passadas na requisição e expressará numericamente seu grau exato de dúvida através da entropia de sua distribuição probabilística.
Matematicamente, enquanto um LLM tradicional otimiza a log-verossimilhança negativa em nível de token (L_LLM = -sum log P(w_t | w_
Para permitir que qualquer desenvolvedor estruture qualquer lógica de negócio sem ambiguidade, o Jev organiza todas as suas capacidades em torno de três primitivas matemáticas fundamentais. Não existem “prompts livres” ou textos abertos; todas as indagações ao Jev são instâncias de Noul, Choice ou Score.
O nome Noul é uma fusão semântica e elegante de “Null” (referência à hipótese nula estatística $H_0$) e “Boolean”. Ao contrário de um simples tipo booleano de programação que só pode assumir
Casos de Uso Primários:
A primitiva Choice é o mecanismo supremo de roteamento e classificação. Ela permite ao desenvolvedor definir um conjunto fechado de alternativas possíveis (chaves) e associar a cada uma delas um critério semântico explícito de enquadramento. O Jev avalia o estado e retorna não apenas a opção vencedora, mas a distribuição completa de densidade de probabilidade sobre todas as opções, acompanhada de um escore de confiança global.
Casos de Uso Primários:
A primitiva Score resolve o desafio de atribuir magnitudes relativas e gradações semânticas a um estado. Ela suporta tanto escalas ordinais discretas baseadas em níveis qualitativos ordenados (por exemplo:
Casos de Uso Primários:
O batismo do modelo com o nome Jev carrega um manifesto econômico profundo. Trata-se de uma homenagem direta ao célebre economista e lógico britânico do século XIX William Stanley Jevons, formulador do famoso Paradoxo de Jevons (1865).
No auge da Revolução Industrial, Jevons observou que, ao contrário do senso comum que previa que a invenção de motores a vapor mais eficientes diminuiria o consumo total de carvão na Inglaterra, o aumento drástico na eficiência do motor tornou a energia do carvão tão barata e acessível que a demanda agregada por carvão explodiu em milhares de novas indústrias que antes não podiam pagar por ele. O resultado final foi um aumento astronômico no consumo total de carvão.
Diogo Almeida e os investidores da DCVC aplicaram essa exata lei econômica à inteligência de máquina:
Enquanto os modelos de ponta de linguagem cobram entre US$ 2,50 e US$ 15,00 por milhão de tokens de entrada e dezenas de dólares por milhão de tokens de saída, a TypeSafe AI fixou a precificação do Jev em US$ 0,042 por milhão de tokens de entrada. E mais impressionante ainda: os tokens de saída são 100% gratuitos (US$ 0,00), pois como o Jev não cospe texto tokenizado, a empresa não precisa alocar computação para gerar fluxos de texto de resposta.
Ao derrubar a barreira de custo em até 80 vezes em relação aos modelos de primeira linha e zerar a cobrança de saída com latência abaixo de 200 milissegundos, o Jev desencadeia o Paradoxo de Jevons na prática. Engenheiros agora podem injetar inferência de inteligência artificial em lugares impensáveis até ontem:
Uma dúvida comum entre líderes técnicos e arquitetos é: “Por que não continuar utilizando classificadores tradicionais de Machine Learning (como BERT, RoBERTa, XGBoost ou embeddings) que também rodam rápido?”
A resposta revela o golpe de mestre do Jev: ele combina o melhor dos dois mundos, eliminando as desvantagens de ambos.
A elegância do Jev se expressa de maneira mais palpável quando examinamos o código fonte de uma integração real. Vamos acompanhar agora um guia completo de implementação em Python e TypeScript, explorando o poder do
O pacote oficial da TypeSafe AI é distribuído via PyPI e npm. Para instalar a biblioteca no seu ambiente Python:
A biblioteca buscará automaticamente a chave de API definida na variável de ambiente
No exemplo a seguir, avaliamos simultaneamente a urgência (Noul), o departamento de destino (Choice) e o grau de frustração (Score) de um chamado com apenas uma única requisição ao Jev, executada em menos de 150 milissegundos:
Para arquiteturas baseadas em microsserviços Node.js, Cloudflare Workers ou plataformas serverless, a comunicação com o endpoint de baixa latência do Jev pode ser realizada diretamente via requisição HTTP POST padrão:
Em pipelines avançados de orquestração de agentes autônomos com o LangGraph, a substituição de nós de decisão LLM por chamadas ao Jev transforma a performance e a estabilidade da esteira:
Um dos erros conceituais mais comuns nas discussões iniciais sobre o Jev foi a suposição ingênua de que a TypeSafe AI estaria tentando matar os modelos generativos como GPT-4, Claude ou Gemini. A realidade é exatamente o oposto: o Jev é o melhor amigo dos LLMs de grande porte.
No ecossistema de desenvolvimento de agentes autônomos (construídos sobre frameworks como LangChain, LangGraph, CrewAI, LlamaIndex ou AutoGen), um dos maiores gargalos de confiabilidade e latência é a fase de roteamento e despacho de ferramentas (*Tool Calling / Tool Routing*). Frequentemente, desenvolvedores observam seus agentes entrarem em loops infinitos, acionando ferramentas erradas ou gastando 4 segundos de processamento apenas para decidir se o usuário solicitou uma pesquisa na web ou se estava apenas agradecendo com um "obrigado!".
A arquitetura moderna que emergiu nos últimos meses é a Arquitetura de Duplo Córtex (Two-Cortex Architecture):
Essa sinergia reduz os custos operacionais de faturas de nuvem de agentes em até 85%, ao mesmo tempo em que reduz a latência percebida pelo usuário em mais de 70% na maioria das interações rotineiras.
Desde a abertura de seu acesso preliminar para empresas parceiras no início de setembro de 2026, o Jev encontrou tração voraz em verticais de negócios com altíssimo volume de processamento e tolerância zero a latência e alucinações.
Em sistemas de autorização de transações financeiras e checkout transparente, as regras de conformidade e as bandeiras de cartão impõem tempos limite severos (frequentemente de menos de 400 milissegundos para a decisão completa da transação). Nenhuma empresa de pagamentos podia arriscar colocar um modelo como o GPT-4o no caminho crítico do checkout devido à latência de 2 segundos. Com o Jev respondendo em 80ms, fintechs passaram a avaliar o payload completo de telemetria da transação, verificando probabilidade de chargeback e orquestrando desafios de autenticação de dois fatores (2FA) em voo antes de autorizar o débito.
Operações de teleatendimento e suporte receptivo que lidam com dezenas de milhares de mensagens por hora eliminaram regras manuais de triagem baseadas em palavras-chave frágeis (como "URGENTE", "CANCELAR", "PROBLEMA") e as substituíram por instâncias do Jev. O sistema enquadra cada conversa em filas especializadas, calcula a probabilidade de escalonamento executivo e marca o humor do cliente em tempo real, permitindo que os supervisores priorizem clientes em risco crítico de rompimento comercial.
Plataformas de monitoramento e centros de operações de segurança (SOC) ingerem petabytes de logs por dia. A grande maioria dos alertas do PagerDuty ou Datadog são falsos positivos que causam fadiga brutal de alertas nas equipes de engenharia de confiabilidade de sites (SREs). Empresas de segurança estão utilizando o Jev para digerir milhões de linhas de rastreio em tempo real, filtrando ruído normal de operação e disparando alarmes sonoros apenas quando o Jev atribui probabilidade superior a 0,95 para anomalias genuínas ou vetores conhecidos de invasão.
Grandes marketplaces sofrem diariamente com o cadastramento caótico de produtos por parte de terceiros. Com o Jev, imagens convertidas em vetores e títulos bagunçados de produtos são automaticamente classificados em árvores de categoria de 5 níveis em milissegundos, enquanto análises contínuas de Score verificam a conformidade do anúncio com as diretrizes do marketplace.
Ambientes corporativos modernos orquestrados em clusters Kubernetes (AWS EKS, Google GKE ou bare-metal on-premises) enfrentam diariamente dezenas de incidentes automatizados: eventos de
Tradicionalmente, a esteira de observabilidade despacha esses alertas para o canal de plantão da equipe no Slack ou aciona o PagerDuty na madrugada. No entanto, mais de 70% desses incidentes decorrem de causas transitórias ou de fácil remediação que poderiam ser sanadas em segundos por automações fechadas. Ao integrar o Jev diretamente no ciclo de tratamento de webhooks do Prometheus Alertmanager ou Datadog, a equipe de SRE obtém uma triagem em 90 milissegundos que avalia o log da aplicação e o manifesto do pod contra três perguntas críticas:
Se o Jev retornar probabilidade de transitoriedade superior a 0,92 e apontar para
Em setores altamente regulados — como seguros, saúde e bancário —, a transferência inadvertida de Informações Pessoais Identificáveis (PII, como CPF, números de cartão de crédito, prontuários médicos ou senhas) para provedores de nuvem pública pode gerar penalidades legais catastróficas.
Com o Jev rodando como um proxy reverso ou middleware interceptador em frente aos sistemas corporativos, cada requisição recebida passa por uma varredura semântica instantânea em milissegundos, impedindo vazamentos antes que o payload toque qualquer camada persistente ou modelo generativo externo:
Em sistemas de missão crítica, cada milissegundo de atraso em cascata degrada a experiência do cliente e derruba as taxas de conversão de checkouts. Ao estruturar um Latency Budget de 300ms para uma operação de busca ou recomendação, arquitetos de software não podem aceitar uma variabilidade de 2.000ms a 5.000ms típica de chamadas a grandes LLMs.
O Jev atua como a garantia de estabilidade nos percentis de cauda (P99 e P99.9). Enquanto a latência de um LLM flutua violentamente dependendo da carga dos data centers do provedor e da quantidade de tokens de saída gerados, o Jev apresenta desvio-padrão de latência quase plano, garantindo que o percentil P99 permaneça confinado abaixo de 220ms mesmo em momentos de pico de tráfego de Black Friday.
Nenhuma análise tecnológica madura é completa sem examinar de forma rigorosa as restrições e críticas em torno de uma inovação. E no caso do Jev, os debates técnicos e as divergências de mercado têm sido intensos.
A principal crítica inicial de alguns desenvolvedores acostumados à magia fácil dos chatbots é a constatação literal de que o Jev é um modelo mudo. Ele não sabe conversar, não sabe contar piadas, não produz resumos em texto corrido e não gera código-fonte. Se você pedir ao Jev para redigir um e-mail de resposta para um cliente irritado, ele simplesmente falhará, pois seu motor interno não possui as cabeças de decodificação sintática necessárias para emitir strings de texto livre.
A TypeSafe AI reforça que essa "mudez" não é um defeito de engenharia, mas sua principal virtude arquitetural. A impossibilidade de gerar texto livre é exatamente a garantia matemática que torna o modelo imune a alucinações, vazamento de prompts ou quebras inesperadas de schema de dados. Ainda assim, para equipes que buscam uma solução "tudo em um" para interação direta com humanos, o Jev sozinho é insuficiente, exigindo obrigatoriamente a composição com um modelo generativo convencional.
Outra queixa frequente da comunidade open-source e de desenvolvedores independentes diz respeito à política de distribuição da TypeSafe AI. No momento atual (setembro de 2026), o modelo opera em regime de Private Early Access (Acesso Antecipado Fechado) através de lista de espera no portal
Analistas de mercado do Gartner e publicações como a Towards AI apontam que o sucesso do Jev já acendeu o sinal de alerta nos quartéis-generais de Meta, Google, Microsoft e OpenAI. É amplamente esperado que a Meta apresente nos próximos meses ramificações não-autoregressivas especializadas da família Llama, e que a própria OpenAI responda com novas primitivas em sua API para competir diretamente na faixa de sub-centavos por decisão.
Para os engenheiros e entusiastas que desejam aprofundar seu entendimento assistindo às demonstrações práticas, benchmarks ao vivo e entrevistas exclusivas com os fundadores, reunimos abaixo os principais registros audiovisuais que cobriram a ascensão do Jev:
No presente momento, o Jev é disponibilizado exclusivamente como uma API gerenciada pela TypeSafe AI hospedada em clusters globais de baixa latência. No entanto, a empresa sinalizou em seus comunicados institucionais que contratos corporativos de nível Enterprise poderão contemplar implantações privadas em VPC (Virtual Private Cloud) via AWS, Azure ou Google Cloud.
O Jev possui uma janela de contexto de atenção projetada para processar eficientemente estados de até dezenas de milhares de tokens. No entanto, para documentos colossais com centenas de páginas, a prática recomendada de arquitetura consiste em alimentar o Jev com chunks relevantes recuperados via busca vetorial (RAG) ou sumarizações prévias, garantindo que a resposta permaneça na faixa de milissegundos.
Sim. O treinamento do Jev contemplou corpora multilíngues abrangentes. Ele compreende nativamente português (PT-BR), espanhol, francês, alemão, italiano, mandarim e japonês, permitindo que as instruções das perguntas e os critérios das opções sejam redigidos em português sem qualquer perda de calibração ou precisão estatística.
As logprobs de um LLM representam a probabilidade condicional de emissão do próximo fragmento textual imediato, sofrendo severa distorção pela distribuição semântica do vocabulário e pela temperatura de amostragem. Já as probabilidades do Jev são calibradas via RLCD contra a verdade factual do mundo: quando o Jev reporta 0,90 de probabilidade, a afirmação tem uma chance empírica comprovada de 90% de correspondência com a realidade da distribuição observada.
Desenvolvedores podem se cadastrar na lista de espera oficial através do portal
Este relatório especial foi construído a partir de ampla apuração jornalística, documentação oficial de sistemas distribuídos e artigos seminais da ciência da computação. Abaixo estão catalogadas as principais fontes consultadas:
Sobre o Portal AiPotar: O AiPotar é um portal editorial independente focado em cobertura profunda de Inteligência Artificial, Engenharia de Dados, Arquiteturas Multi-Agente e Sistemas Avançados de Software.
7. As Três Primitivas Centrais: Noul, Choice e Score em Detalhes
Primitiva 1
Noul (Julgamento Booleano Probabilístico / Teste de Hipótese Nula)
true ou false de forma cega, o Noul avalia uma proposição afirmativa contra o estado fornecido e retorna um valor numérico contínuo no intervalo $[0.0, 1.0]$, representando a probabilidade empírica de a proposição ser verdadeira.
Primitiva 2
Choice (Decisão Categórica Multiclasse com Critérios Semânticos)
billing, tech_support, enterprise_sales ou legal.query_database, send_email, search_web ou ask_user.
Primitiva 3
Score (Avaliação em Escala Ordinal ou Métrica Contínua)
["Calmo", "Levemente Irritado", "Frustrado", "Furioso"]) quanto intervalos numéricos contínuos calibrados. Em vez de uma pontuação arbitrária gerada por aproximação de texto, o Jev calcula a massa de probabilidade distribuída ao longo dos níveis da régua, garantindo consistência estatística perfeita entre chamadas consecutivas.
8. A Economia Radical de Tokens e o Paradoxo de Jevons Aplicado à Computação
9. Comparativo Técnico: Jev vs LLMs Generativos vs Modelos Tradicionais de NLP (BERT/Scikit-Learn)
10. Engenharia Prática: Tutorial Completo com TypeSafe Python SDK, REST API e LangGraph
typesafe-sdk.
Instalação e Configuração
pip install typesafe-sdk
TYPESAFE_API_KEY. Você pode configurá-la no seu terminal ou em um arquivo .env:
export TYPESAFE_API_KEY="ts_live_xxxxxxxxxxxxxxxxxxxxxxxxxxxxx"
Exemplo 1: Triagem e Roteamento Multidimensional de Tíquetes em Tempo Real
from typesafe_sdk import TypeSafeClient, Noul, Choice, Score

# Inicializa o cliente conectado à nuvem global da TypeSafe AI
client = TypeSafeClient()

# Mensagem não-estruturada de um cliente de grande porte
ticket_payload = """
Prezados, estou há três dias consecutivos tentando efetuar os repasses dos meus fornecedores
através da API de pagamentos de vocês e todas as chamadas retornam erro 500 ou timeout.
Já abri dois chamados anteriores e não obtive nenhuma resposta aceitável. Se isso não for
resolvido até as 17h de hoje, cancelaremos nosso contrato corporativo imediatamente e
acionaremos nosso departamento jurídico por perdas e danos!
"""

# Dispara a avaliação em System One em uma única passagem paralela
decision = client.system_one(
    state=ticket_payload,
    questions={
        "urgencia_critica": Noul(
            instructions="O cliente impõe prazo iminente ou ameaça danos contratuais/financeiros imediatos?"
        ),
        "departamento": Choice(
            instructions="Para qual equipe este chamado deve ser imediatamente atribuído?",
            criteria={
                "incidentes_pagamentos": "Falhas técnicas em transações, erros 500 na API, conciliação e repasses",
                "suporte_infraestrutura": "Problemas de DNS, lentidão de rede, certificados SSL e status geral",
                "sucesso_retencao": "Ameaças diretas de churn, cancelamento de contrato corporativo e reclamações de SLA",
                "financeiro_cobranca": "Boletos de assinatura, notas fiscais, estornos rotineiros e dúvidas de preço"
            }
        ),
        "nivel_frustracao": Score(
            instructions="Avalie a intensidade do desgaste emocional do interlocutor:",
            levels=[
                "Tranquilo / Informativo",
                "Incomodado / Impaciente",
                "Altamente Frustrado",
                "Hostil / Ameaça Iminente"
            ]
        )
    }
)

# Acesso direto aos valores fortemente tipados com garantias estatísticas
is_urgente = decision.noul_value("urgencia_critica")
setor_escolhido = decision.choice_value("departamento")
confianca_setor = decision.choice("departamento").confidence
score_frustracao = decision.score_value("nivel_frustracao")

print(f"Probabilidade de Urgência: {is_urgente:.4f}")  # Exemplo: 0.9842
print(f"Equipe Destino: {setor_escolhido} (Confiança: {confianca_setor:.4f})") # Exemplo: incidentes_pagamentos (0.9412)
print(f"Grau de Desgaste: {score_frustracao}")         # Exemplo: Hostil / Ameaça Iminente

# Regra de automação pura sem regex, sem parsers e sem risco de crash
if is_urgente > 0.90 and confianca_setor > 0.85:
    print("🚨 AÇÃO AUTOMÁTICA: Disparando pager no Slack do time de Pagamentos e criando bridge de crise!")
else:
    print("ℹ️ Chamado alocado na esteira padrão com prioridade média.")
Exemplo 2: Integração via REST API Nativa em Node.js / TypeScript
import axios from 'axios';

interface SystemOneResponse {
  results: {
    fraude_potencial: { type: 'noul'; probability: number };
    perfil_risco: { type: 'choice'; selected: string; confidence: number };
  };
  latency_ms: number;
}

async function verifyTransactionSafety(transactionState: object) {
  const response = await axios.post<SystemOneResponse>(
    'https://api.typesafe.ai/v1/systemone',
    {
      state: JSON.stringify(transactionState),
      questions: {
        fraude_potencial: {
          type: 'noul',
          instructions: 'Há incompatibilidade grave de geolocalização ou anomalia de velocidade de transação?'
        },
        perfil_risco: {
          type: 'choice',
          instructions: 'Qual a conduta prudencial para este checkout?',
          criteria: {
            aprovar_imediato: 'Padrão habitual do portador e baixa quantia',
            exigir_biometria: 'Dispositivo inédito ou horário atípico com quantia média',
            bloquear_preventivo: 'Múltiplas tentativas de cartão com dados divergentes'
          }
        }
      }
    },
    {
      headers: {
        'Authorization': `Bearer ${process.env.TYPESAFE_API_KEY}`,
        'Content-Type': 'application/json'
      },
      timeout: 1000 // Timeout agressivo de 1 segundo
    }
  );

  const { fraude_potencial, perfil_risco } = response.data.results;
  console.log(`Inferência concluída em ${response.data.latency_ms}ms`);

  return {
    fraudProbability: fraude_potencial.probability,
    recommendedAction: perfil_risco.selected,
    confidence: perfil_risco.confidence
  };
}
Exemplo 3: Roteador de Arestas Condicionais em LangGraph
from typing import Literal
from langgraph.graph import StateGraph, END
from typesafe_sdk import TypeSafeClient, Choice

client = TypeSafeClient()

class AgentState(dict):
    user_query: str
    intermediate_data: dict
    next_node: str

def fast_system_one_router(state: AgentState) -> Literal["sql_query_tool", "web_search_tool", "direct_llm_response"]:
    """
    Avalia a intenção em menos de 100ms usando o Jev,
    eliminando a necessidade de invocar um modelo de 70B para roteamento básico.
    """
    decision = client.system_one(
        state=state["user_query"],
        questions={
            "tool_selection": Choice(
                instructions="Qual o melhor destino para atender esta mensagem do usuário?",
                criteria={
                    "sql_query_tool": "Consultas a dados internos de faturamento, estoque, vendas ou métricas",
                    "web_search_tool": "Perguntas sobre notícias externas, cotações em tempo real ou clima",
                    "direct_llm_response": "Cumprimentos, perguntas gerais de conhecimento ou conversação aberta"
                }
            )
        }
    )

    selected_tool = decision.choice_value("tool_selection")
    confidence = decision.choice("tool_selection").confidence

    # Se a confiança for baixa (< 0.70), despacha para o LLM responder diretamente
    if confidence < 0.70:
        return "direct_llm_response"

    return selected_tool

# Construção do Grafo LangGraph
workflow = StateGraph(AgentState)
workflow.add_node("sql_query_tool", lambda s: {"intermediate_data": "Dados SQL executados"})
workflow.add_node("web_search_tool", lambda s: {"intermediate_data": "Busca web concluída"})
workflow.add_node("direct_llm_response", lambda s: {"intermediate_data": "Resposta sintetizada"})

# Define as arestas condicionais com base no Jev
workflow.set_conditional_entry_point(
    fast_system_one_router,
    {
        "sql_query_tool": "sql_query_tool",
        "web_search_tool": "web_search_tool",
        "direct_llm_response": "direct_llm_response"
    }
)
11. Padrões de Integração Híbrida: Jev como Roteador e Guardrail para Agentes LLM
Blueprint da Arquitetura de Duplo Córtex em Agentes de IA:
12. Casos de Uso Corporativos: Onde o Jev Já Está Transformando a Produção
A. Fintechs, Antifraude e Meios de Pagamento
B. Suporte ao Cliente em Hiperescala (Zendesk / Intercom / Salesforce)
C. Segurança Cibernética, SIEM e Observabilidade de Nuvem
D. E-commerce e Marketplaces: Curadoria e Busca Semântica
E. Engenharia de Confiabilidade (SRE) e Automação de Incidentes em Kubernetes
CrashLoopBackOff, OOMKilled (Out of Memory), falhas de readiness probe e desconexões temporárias de pools de conexão com bancos de dados relacionais.
restart_pod com confiança elevada, o cluster dispara o reinício controlado do deployment e anota o ticket no Jira ou Linear de forma 100% autônoma, reduzindo o Mean Time to Recovery (MTTR) de 25 minutos para meros 4 segundos.
F. Governança de Dados, Mascaramento de PII e Compliance LGPD e GDPR
# Exemplo de Middleware de Proteção de Dados com Jev
async def pii_compliance_middleware(request: Request, call_next):
    body = await request.body()
    sanitized_decision = client.system_one(
        state=body.decode('utf-8'),
        questions={
            "contem_pii_sensivel": Noul("Há menção a CPF, cartão, dados de saúde ou senhas em texto puro?"),
            "classificacao_sigilo": Choice(
                "Qual a classificação da informação?",
                criteria={
                    "publico": "Informações abertas e cadastros gerais",
                    "confidencial": "Dados internos de faturamento ou contratos",
                    "altamente_sensivel": "Credenciais de acesso e prontuários"
                }
            )
        }
    )
    if sanitized_decision.noul_value("contem_pii_sensivel") > 0.85:
        return Response("Requisição bloqueada por conter dados sensíveis expostos.", status_code=400)
    return await call_next(request)
G. Arquitetura de SLA Garantido e Orçamento de Latência (Latency Budget)
13. Limitações Estruturais, Críticas do Mercado e o Conceito de 'Modelo Mudo'
O Conceito de "Modelo Mudo" e Suas Fronteiras
Acesso Fechado e Fila de Espera
console.typesafe.ai. Embora empresas como a Vercel e grandes players corporativos já estejam operando em produção, desenvolvedores individuais e pequenos criadores dependem de aprovação manual para obter chaves de API com cotas elevadas.
A Iminente Corrida das Big Techs e Versões Open-Source
14. Vídeos de Referência, Entrevistas e Discussões Técnicas
15. Perguntas Frequentes (FAQ Técnico & Arquitetura)
1. O Jev pode ser hospedado localmente (On-Premises / Self-Hosted)?
2. Como o Jev lida com textos muito longos ou documentos inteiros?
3. O Jev suporta múltiplos idiomas além do inglês?
4. Qual a diferença exata entre as logprobs do OpenAI e as probabilidades do Jev?
5. Como conseguir acesso ao Jev hoje mesmo?
console.typesafe.ai. Casos de uso corporativos de alto volume com suporte a faturamento corporativo costumam ter prioridade na liberação dos tokens de acesso.
16. Referências Bibliográficas, Fontes Primárias e Leituras Recomendadas
Artigo Original no Brazil Journal
typesafe.ai e console.typesafe.ai.